robots.txt et IA : quels robots bloquer, lesquels laisser passer
· 3 min de lecture
Dans ton robots.txt, la règle à retenir est simple : les robots de recherche des IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot) doivent passer si tu veux être cité dans les réponses ; les robots d'entraînement (GPTBot, ClaudeBot, Google-Extended) peuvent être bloqués si tu refuses que tes pages servent à entraîner les modèles, avec un coût à long terme sur ce qu'ils sauront de toi. Beaucoup de sites bloquent les deux par erreur.
Rappel : comment fonctionne un robots.txt
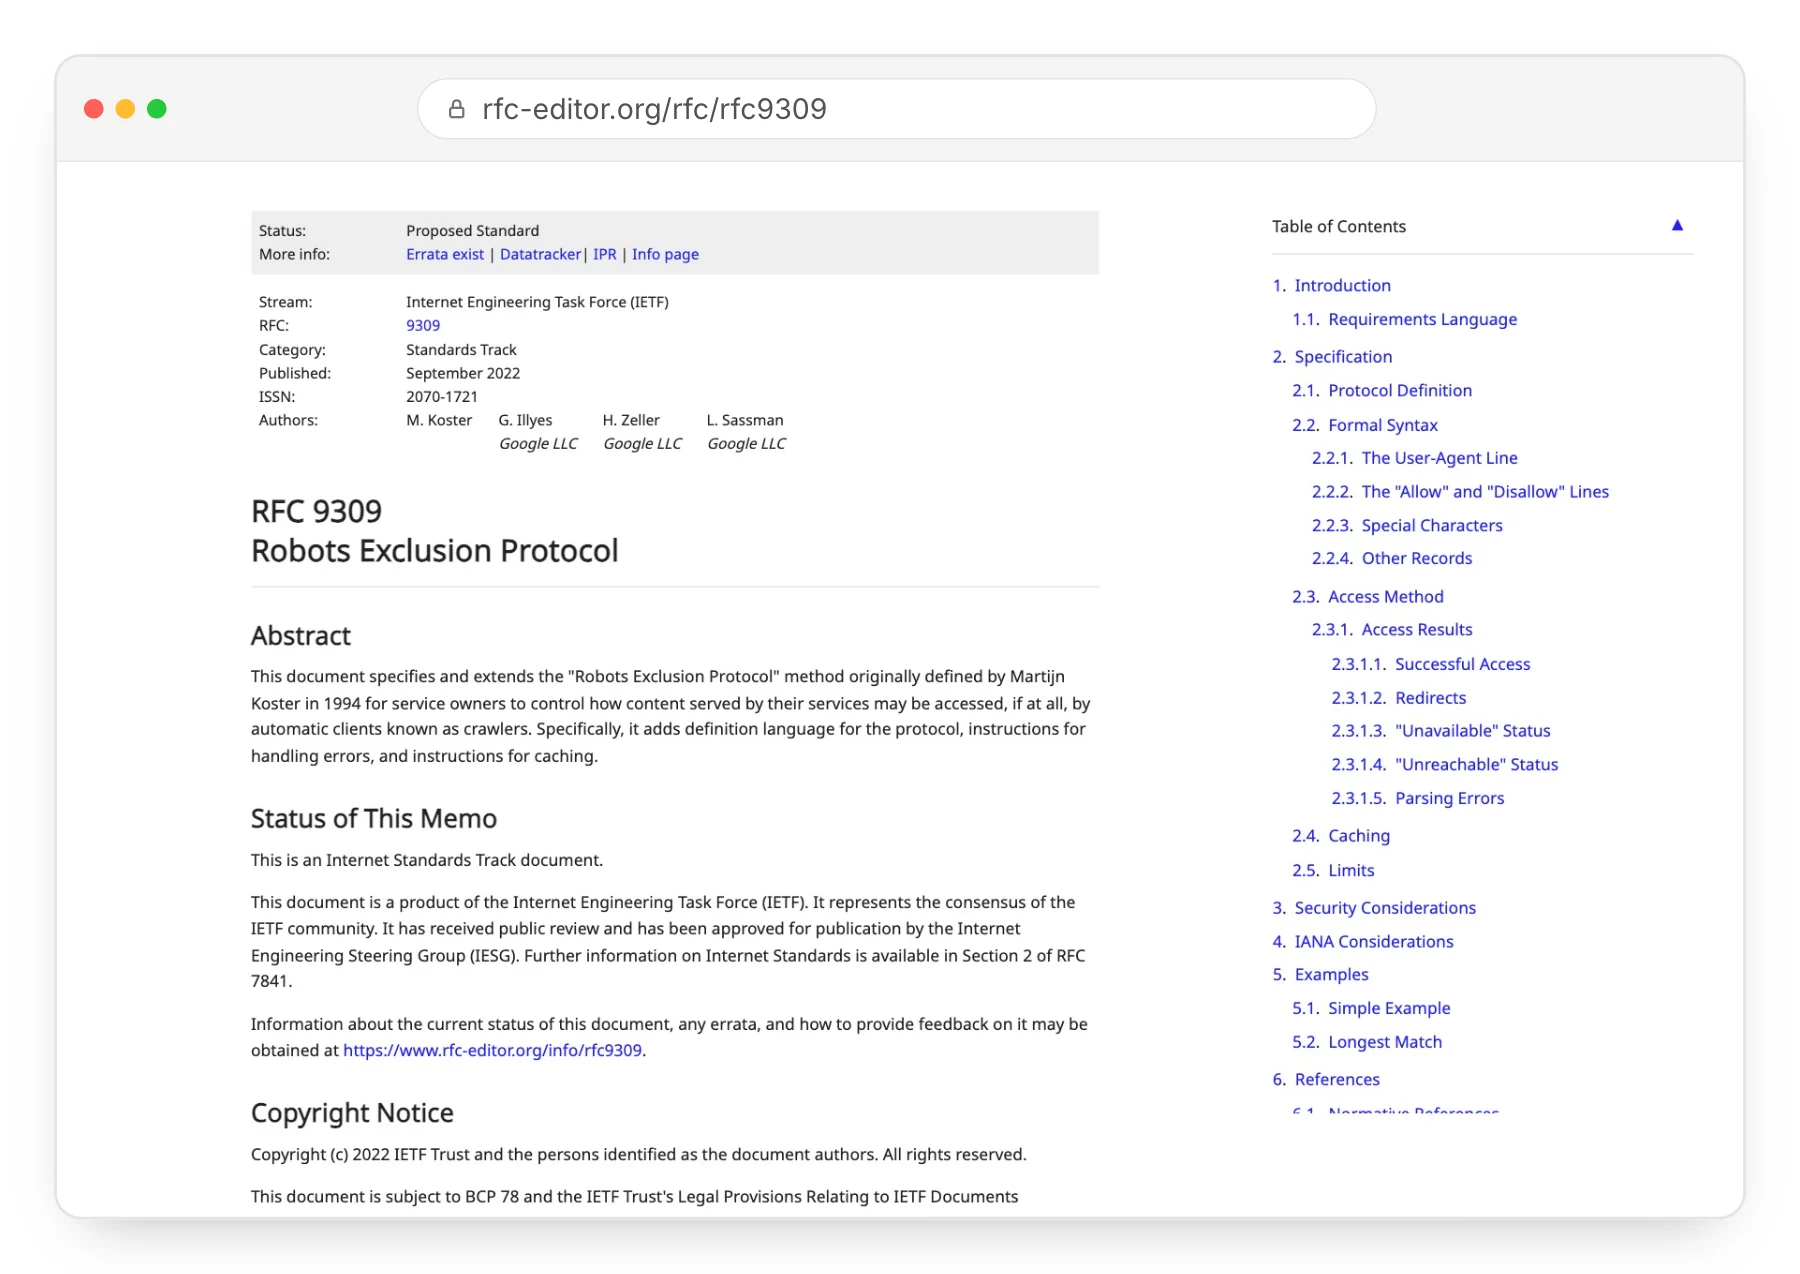
Le robots.txt est un fichier texte à la racine de ton site. Il contient des groupes de règles, chacun introduit par User-agent: (le nom du robot), suivi de Allow: ou Disallow: (les chemins autorisés ou interdits). Son format a été standardisé en 2022 dans la RFC 9309.
Trois règles de lecture comptent :
- un robot suit le groupe qui le nomme le plus précisément, et ignore
User-agent: *s'il a son propre groupe ; - entre deux règles, la plus longue l'emporte ;
- à égalité, Allow l'emporte sur Disallow.
Deux familles de robots, deux décisions
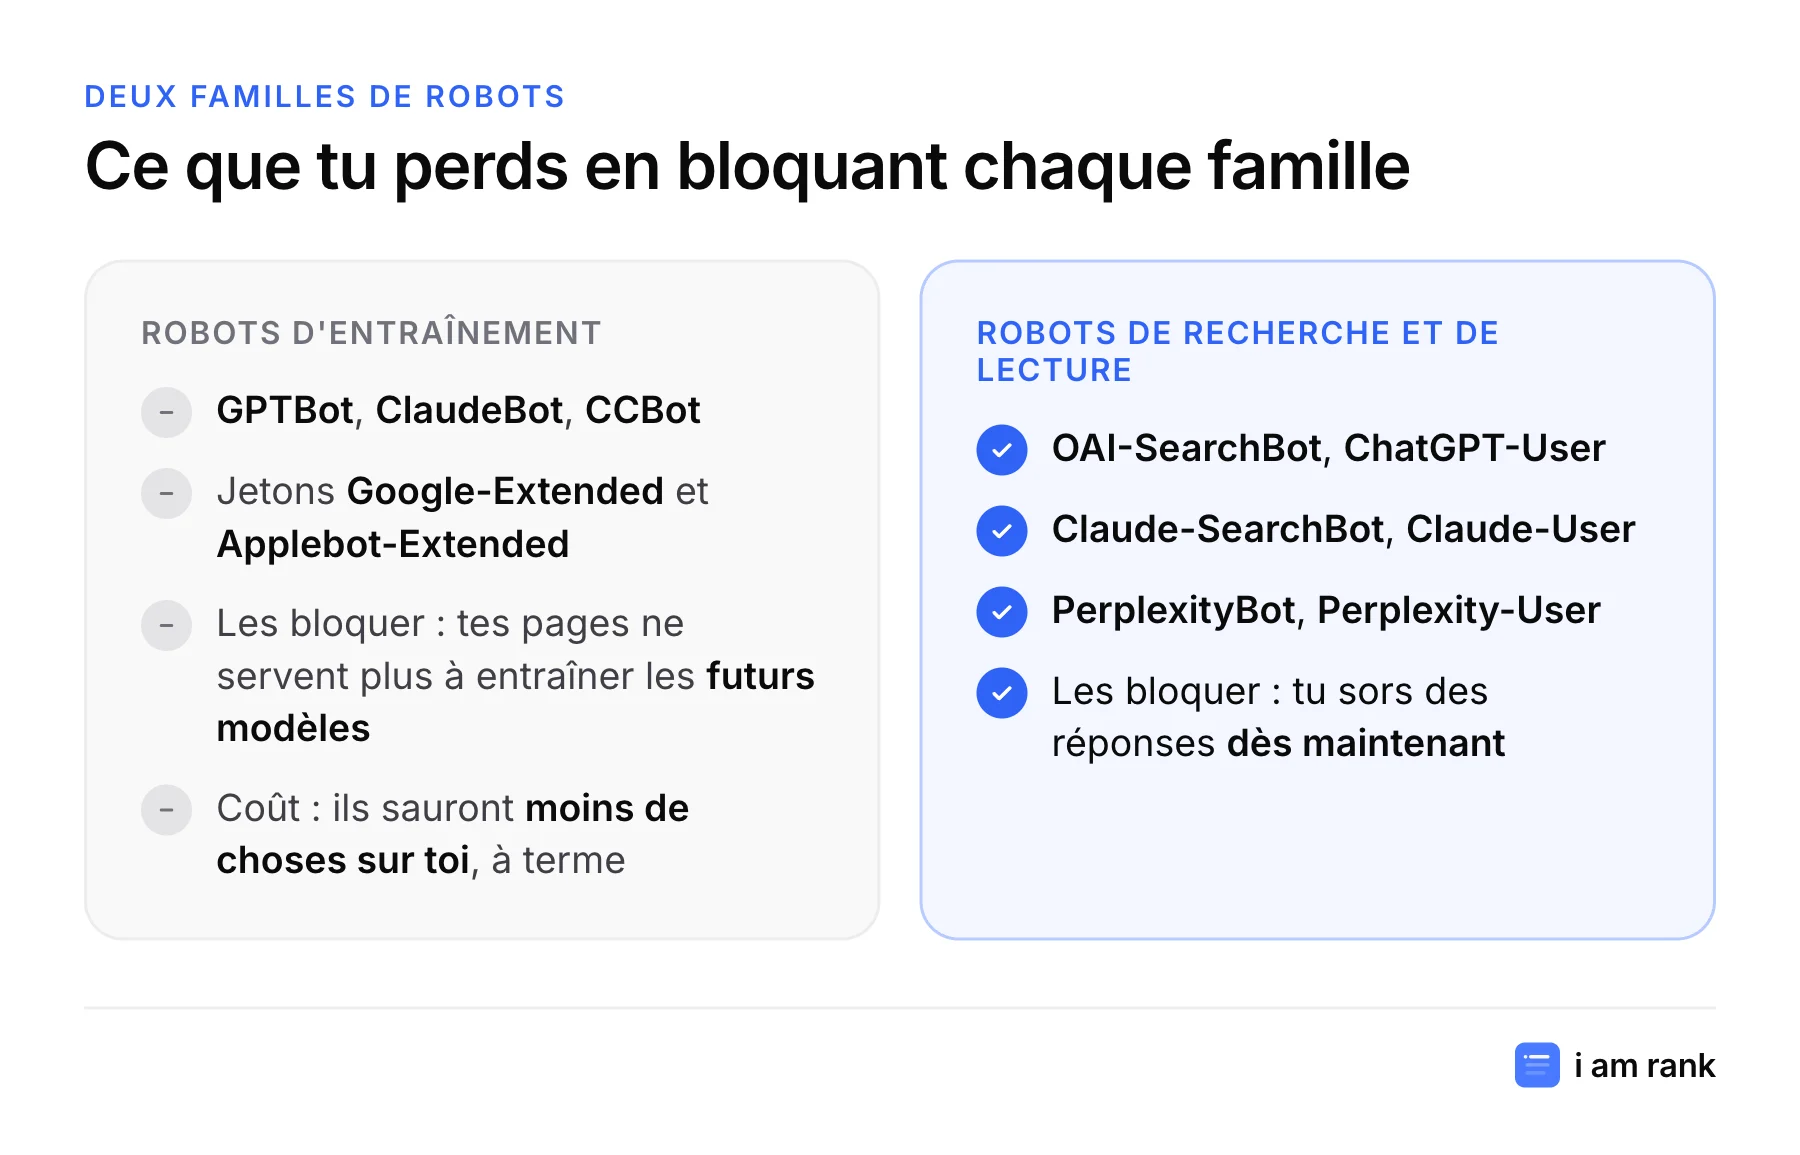
Les robots d'entraînement collectent des pages pour les futurs modèles. Les bloquer est un choix légitime (protection de contenus, droits d'auteur), mais les modèles suivants en sauront moins sur toi, ce qui pèse sur leurs réponses de mémoire.
Les robots de recherche et de lecture récupèrent tes pages pour répondre aux utilisateurs, maintenant. Les bloquer te retire des réponses avec sources. Pour une marque qui veut être recommandée, c'est presque toujours une erreur.
Le rôle de chaque robot est détaillé dans notre liste des robots IA.
Trois robots.txt à copier
Cas 1 : tout ouvrir (le plus courant pour une marque)
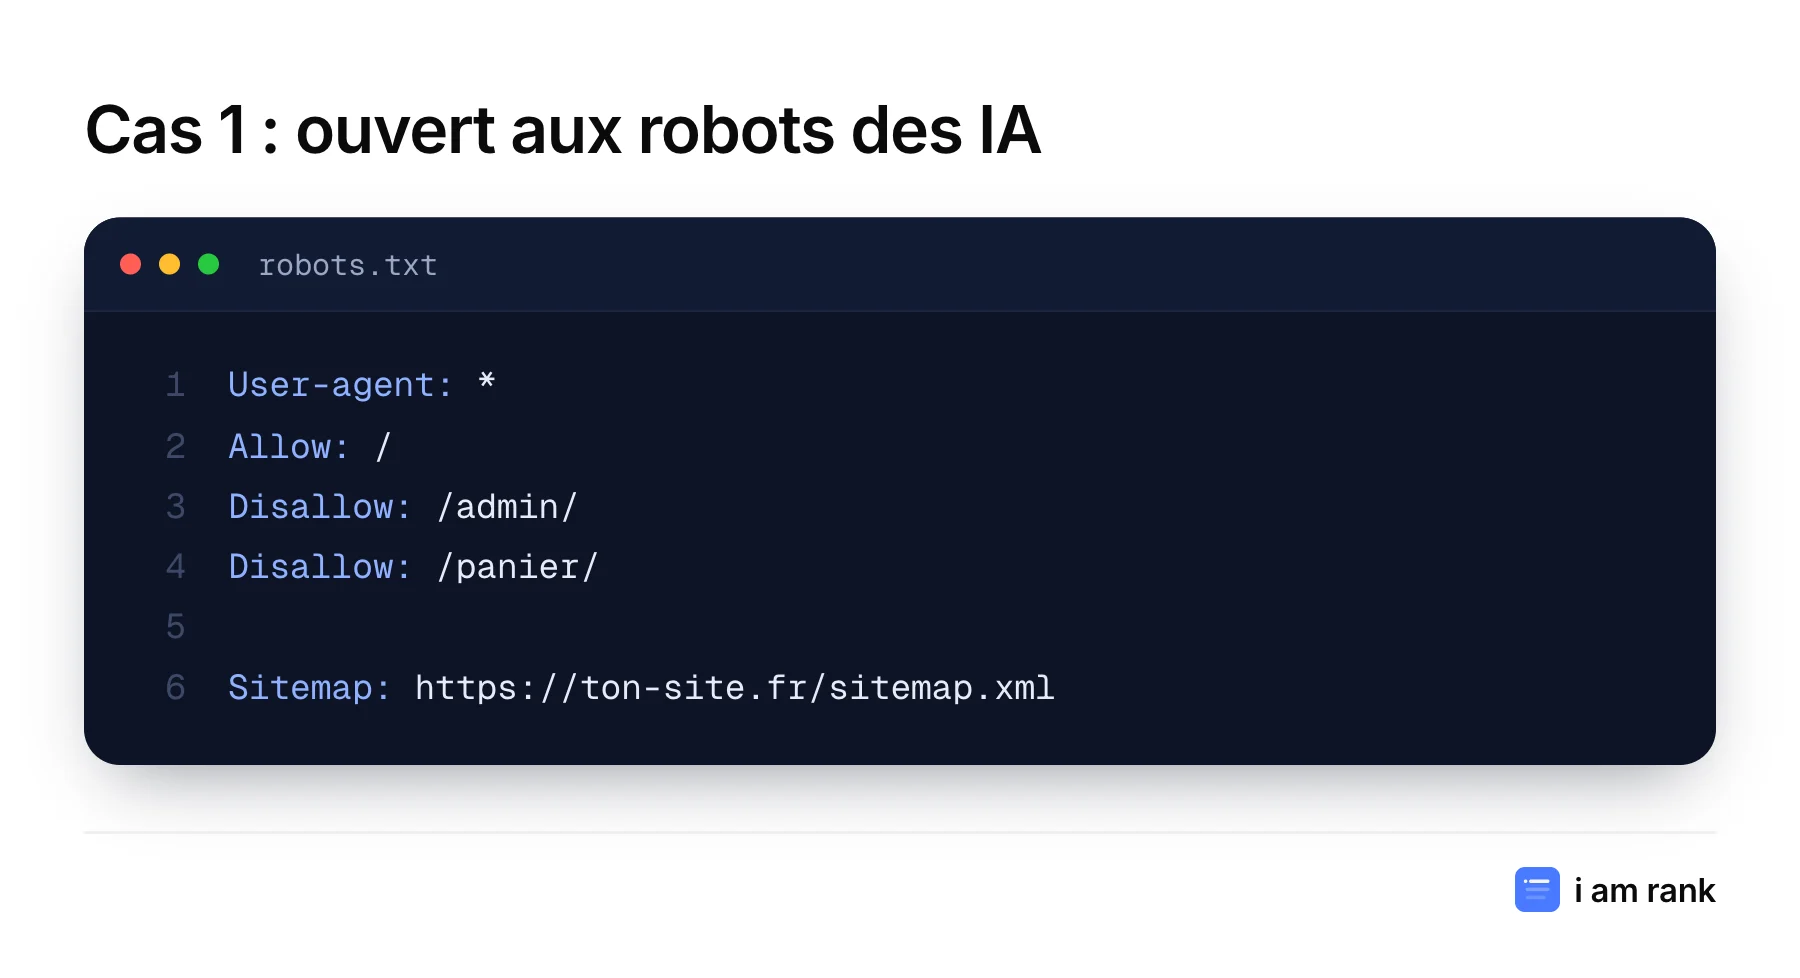
Tous les robots passent, sauf sur les pages sans intérêt (administration, panier, compte client).
Cas 2 : visible dans les réponses, pas dans l'entraînement
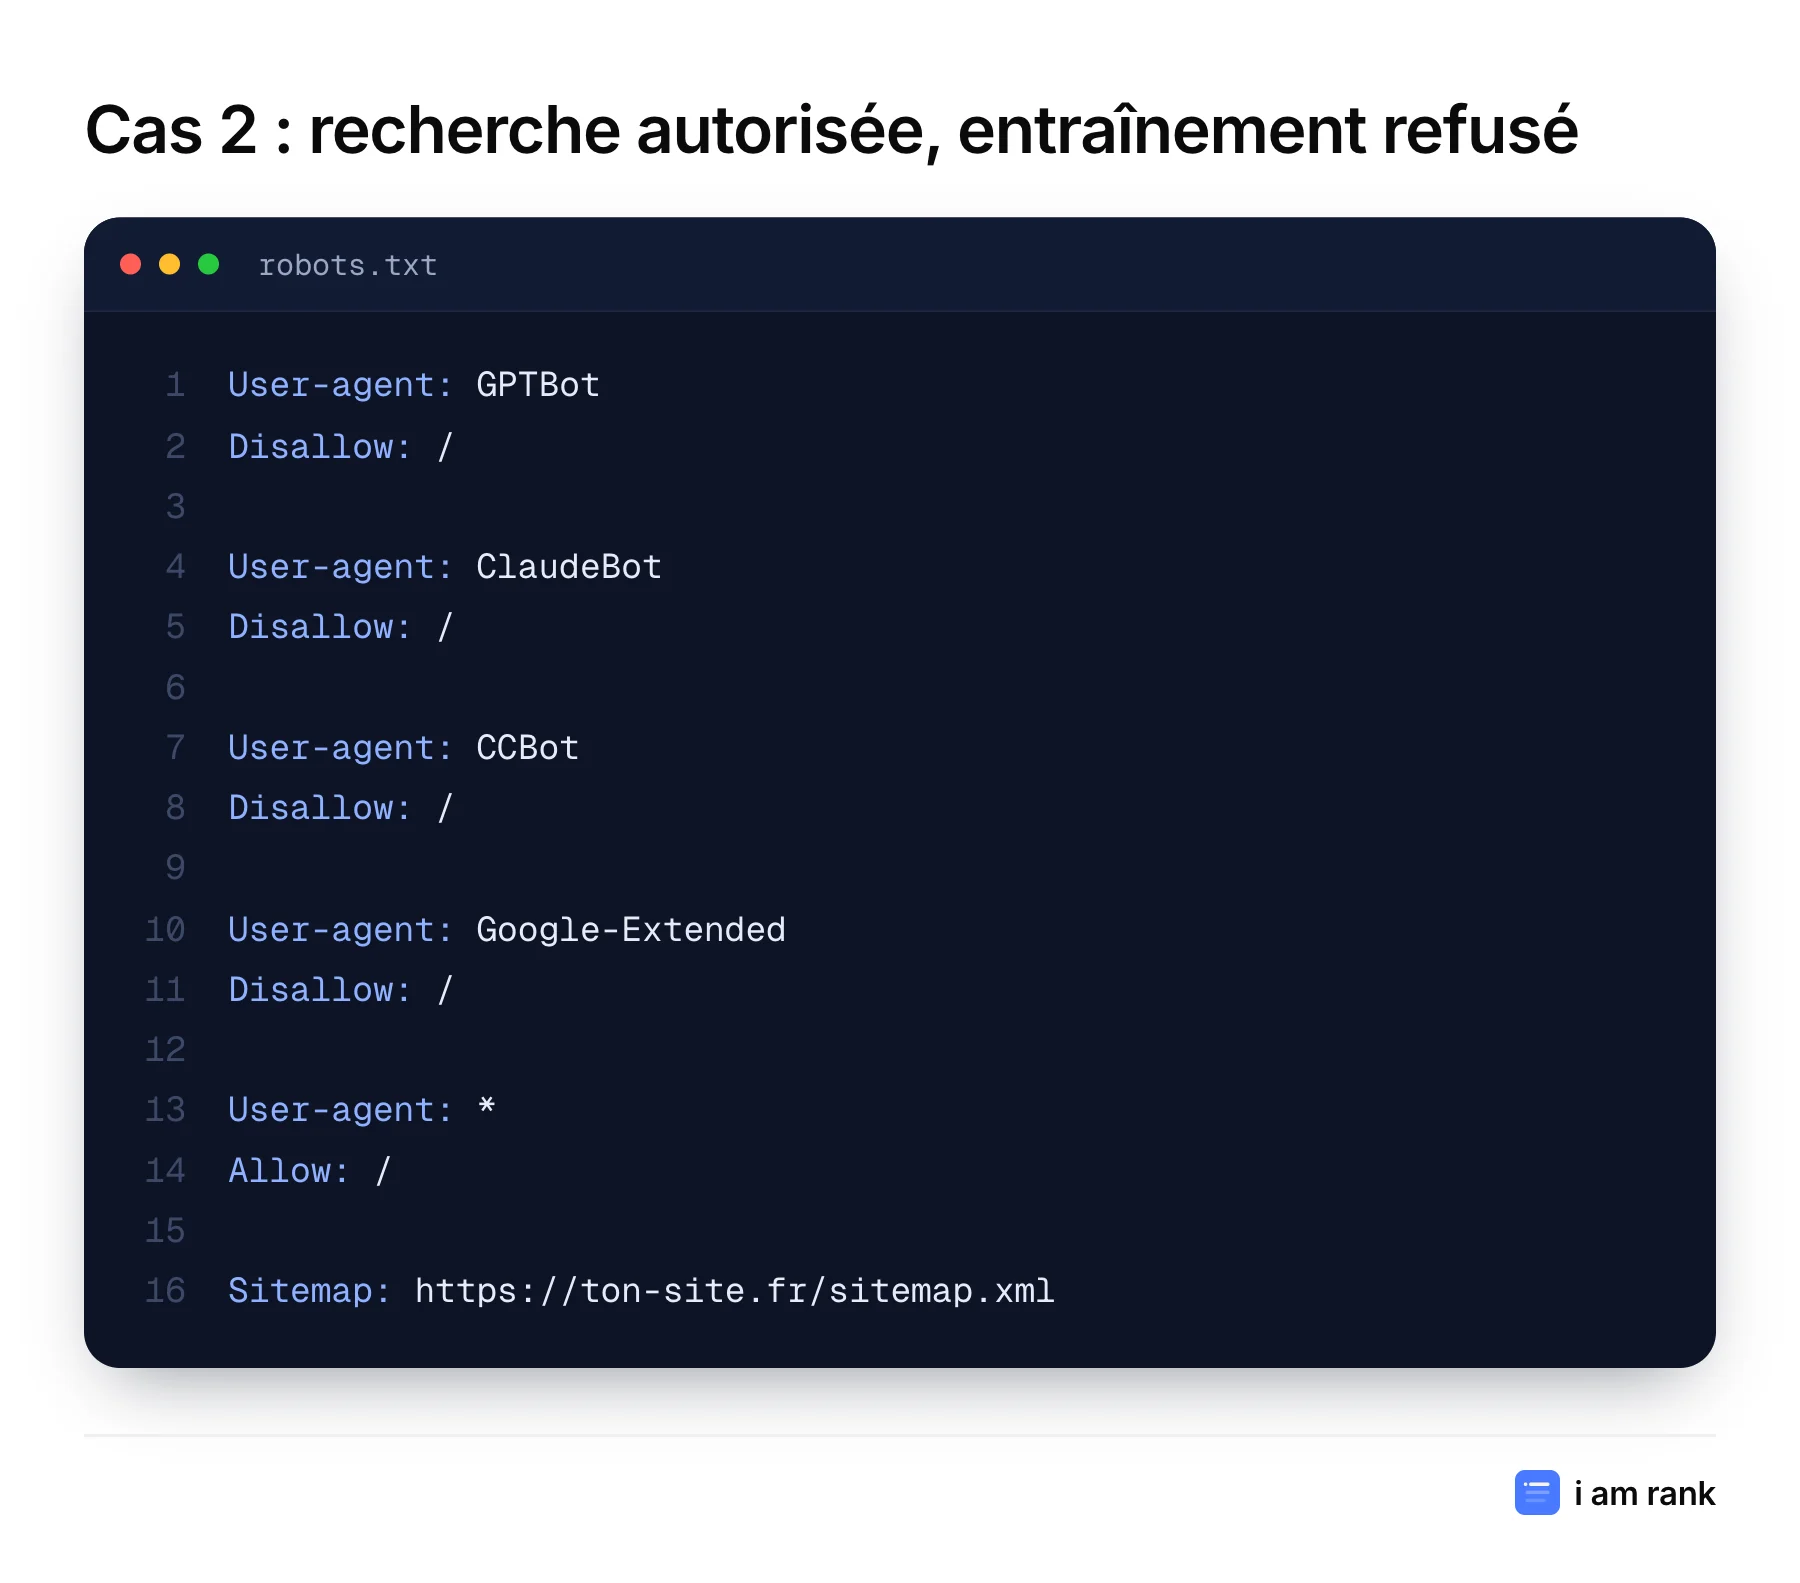
Les robots d'entraînement sont bloqués ; les robots de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot) tombent dans le groupe * et passent. Google-Extended bloqué n'a aucun effet sur les AI Overviews ni sur ton référencement Google : voir Google-Extended, bloquer ou pas.
Cas 3 : tout fermer aux IA
Possible, mais tu disparais des réponses avec sources de ChatGPT, Claude et Perplexity. À réserver aux sites dont le contenu est le produit lui-même (médias payants, bases de données) et qui négocient des accords de licence.
Le piège du pare-feu
Ton robots.txt peut dire oui pendant que ton pare-feu dit non. Les services anti-robots et certains CDN bloquent par défaut les visiteurs automatisés, dont les robots des IA, en renvoyant une erreur 403 ou une page de vérification. Le robots.txt n'y peut rien.
Teste avec le simulateur de crawler IA : il récupère ta page avec l'identité de GPTBot, ClaudeBot et PerplexityBot, lit ton robots.txt et te dit ce que chacun reçoit vraiment.
Les erreurs de robots.txt les plus fréquentes
- Un
Disallow: /hérité d'une préproduction : le site de test bloquait tout, le fichier a été copié en production. Tous les robots sont bloqués, IA comprises. - Un robots.txt qui répond en erreur serveur : selon la RFC 9309, si le fichier est inaccessible à cause d'une erreur serveur (codes 5xx), les robots doivent considérer le site comme entièrement interdit. Un fichier absent (404) vaut au contraire autorisation totale.
- Un seul fichier pour plusieurs domaines : chaque domaine et sous-domaine a son propre robots.txt.
www.ton-site.fretboutique.ton-site.frse règlent séparément. - Des règles trop larges :
Disallow: /pbloque aussi/produitset/prix, puisque les règles portent sur le début du chemin. - Oublier le sitemap : la ligne
Sitemap:aide tous les robots à trouver tes pages.
Les noms de robots, eux, ne sont pas sensibles à la casse : gptbot et GPTBot désignent le même robot.
Questions fréquentes
Les robots des IA respectent-ils le robots.txt ?
Les robots déclarés d'OpenAI, Anthropic, Google et Perplexity disent le respecter. Des acteurs moins scrupuleux peuvent l'ignorer : pour eux, seul un blocage au niveau du serveur ou du pare-feu est efficace.
Faut-il lister chaque robot IA dans mon robots.txt ?
Seulement ceux que tu veux traiter différemment du groupe *. Si tu autorises tout le monde, une règle générale suffit.
Combien de temps pour que le changement soit pris en compte ?
Les robots relisent le robots.txt régulièrement, souvent sous 24 heures. Les pages elles-mêmes sont relues à leur rythme : l'effet sur les réponses peut prendre quelques jours.
Partager l'article
Ressources utiles
- Scan de visibilité IATon score sur 100 en 2 minutes, sur ChatGPT, Claude, Gemini, Perplexity et AI Overviews.
- Générateur de llms.txtEntre l'adresse de ton site, l'IA rédige le fichier.
- Simulateur de crawler IAVois ta page comme GPTBot la voit.
- Calculateur de promptsCombien de questions suivre pour ta marque, et lesquelles.
- Glossaire GEOLes mots de la visibilité IA, expliqués simplement.